
Kwantyzacja modelu: jak skompresować AI, żeby zmieściła się w telefonie
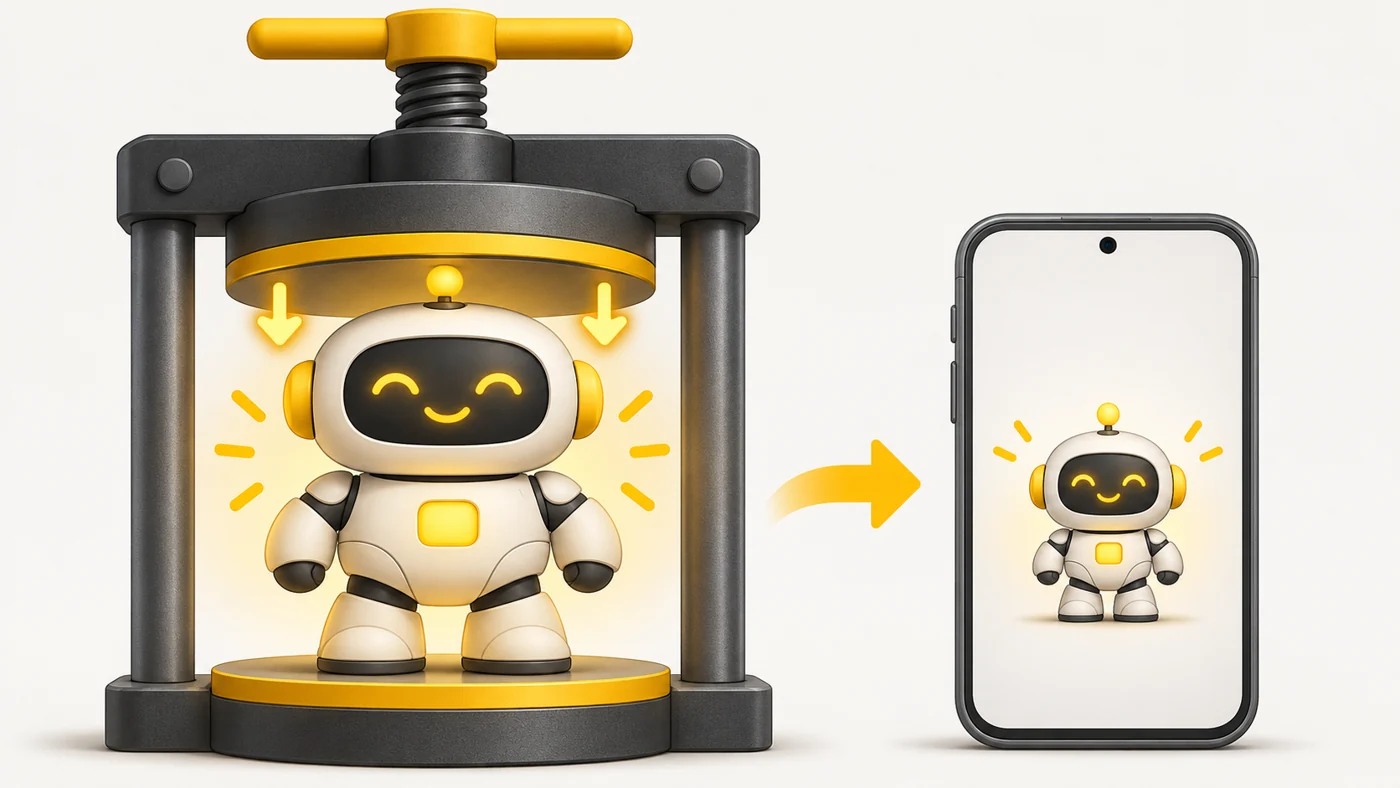
Kwantyzacja to sposób na zmniejszenie sieci neuronowej przez zapisanie jej parametrów mniej dokładnymi liczbami (na przykład 4 bity zamiast 16). Model staje się mniejszy i szybszy, tracąc niewiele jakości.
Prostymi słowami
Wyobraź sobie zdjęcie z 50 megapikseli, które trzeba wysłać w komunikatorze. Kompresujesz je - plik jest kilkadziesiąt razy mniejszy, a na ekranie telefonu prawie nie widać różnicy. Kwantyzacja robi to samo z parametrami modelu: zaokrągla liczby, model „chudnie” kilka razy, a odpowiada prawie tak samo.
Jak to działa
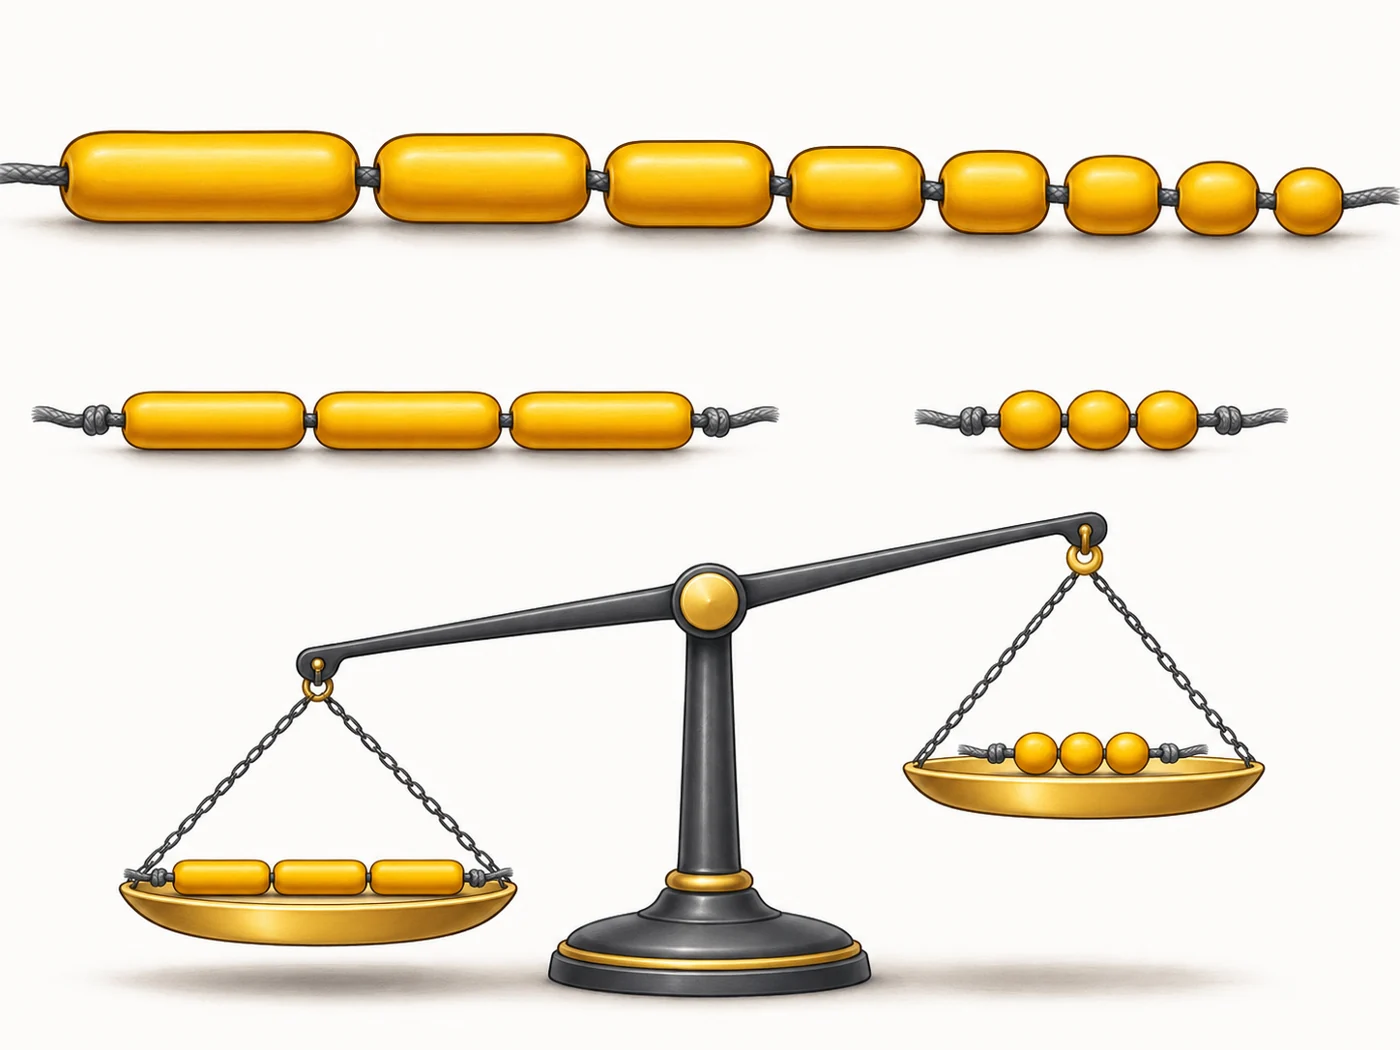
- Parametry modelu zwykle przechowuje się jako liczby 16- lub 32-bitowe.
- Podczas kwantyzacji zaokrągla się je do 8, 4 lub jeszcze mniejszej liczby bitów.
- Model zajmuje kilka razy mniej pamięci i szybciej działa na NPU lub karcie graficznej.
- Sprytne metody zaokrąglają z głową, żeby najważniejsze liczby zachowały precyzję.
- Im mocniejsza kompresja, tym wyraźniej może spaść jakość odpowiedzi.
Gdzie to zobaczysz
Skwantyzowane modele to podstawa AI na urządzeniu: smartfony i laptopy uruchamiają właśnie skompresowane wersje. Entuzjaści, którzy uruchamiają modele na własnym komputerze, widzą oznaczenia typu Q4, Q8, INT4, GGUF - chodzi o poziom kwantyzacji i format pliku.
Czy to ważne przy wyborze
Dla zwykłego użytkownika to niewidoczna praca producenta. Ale jeśli uruchamiasz lokalne modele - tak: wersja 4-bitowa daje rozsądny balans jakości i rozmiaru. To też wyjaśnia, dlaczego obsługa INT4 i INT8 w procesorze neuronowym to przydatna cecha.
Mity
- Mit: Skwantyzowany model to zupełnie inny, gorszy model. W rzeczywistości: To ten sam model, tylko z mniej dokładnymi liczbami. W większości zadań różnica jest niewielka.
- Mit: Można skompresować do 1 bitu bez strat. W rzeczywistości: Im mocniejsza kompresja, tym więcej traci się jakości - cudów nie ma.
Częste pytania
Co oznacza Q4 w nazwie pliku modelu?
Że parametry zapisano mniej więcej czterema bitami - to jedna z najpopularniejszych opcji.
Czy mogę sam skwantyzować model?
Tak, dla modeli otwartych są gotowe narzędzia.
Dlaczego telefony lubią INT8 i INT4?
Bo NPU przetwarza takie krótkie liczby szybciej i przy mniejszym zużyciu energii.
Powiązane pojęcia
Parametry modelu, AI na urządzeniu, Procesor neuronowy (NPU), Modele otwarte