
Ventana de contexto: cuánto puede «recordar» la IA en una conversación
La ventana de contexto es la cantidad máxima de texto (en tokens) que un modelo de lenguaje puede tener en cuenta a la vez: tus mensajes, sus respuestas, los archivos subidos y las instrucciones internas.
En pocas palabras
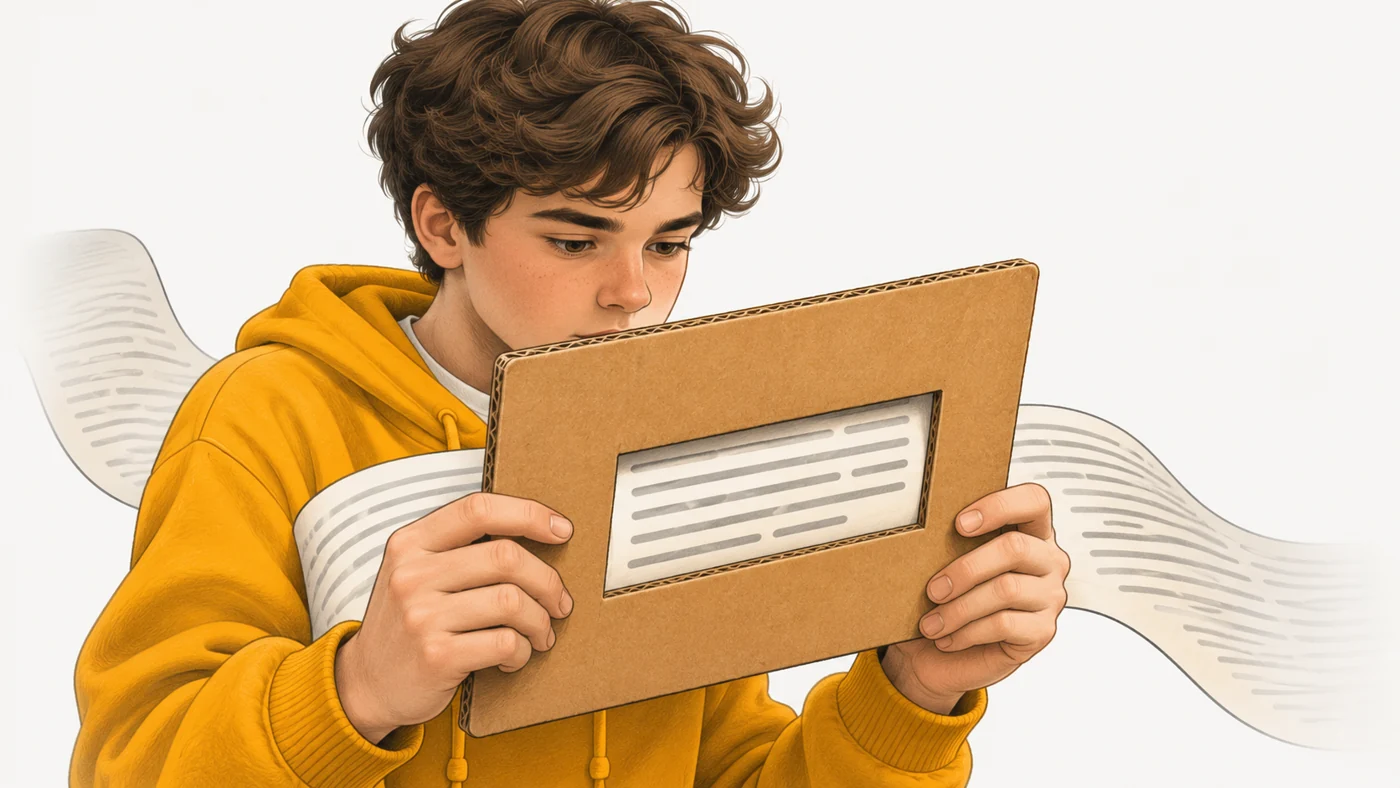
Imagina que lees un libro largo a través de una ventanita recortada en un cartón. Solo ves una página; todo lo anterior queda fuera. La ventana de contexto del modelo es un recorte así. Si es pequeño, el modelo «olvida» el principio de la conversación. Si es grande, cabe un libro entero debajo.
Cómo funciona
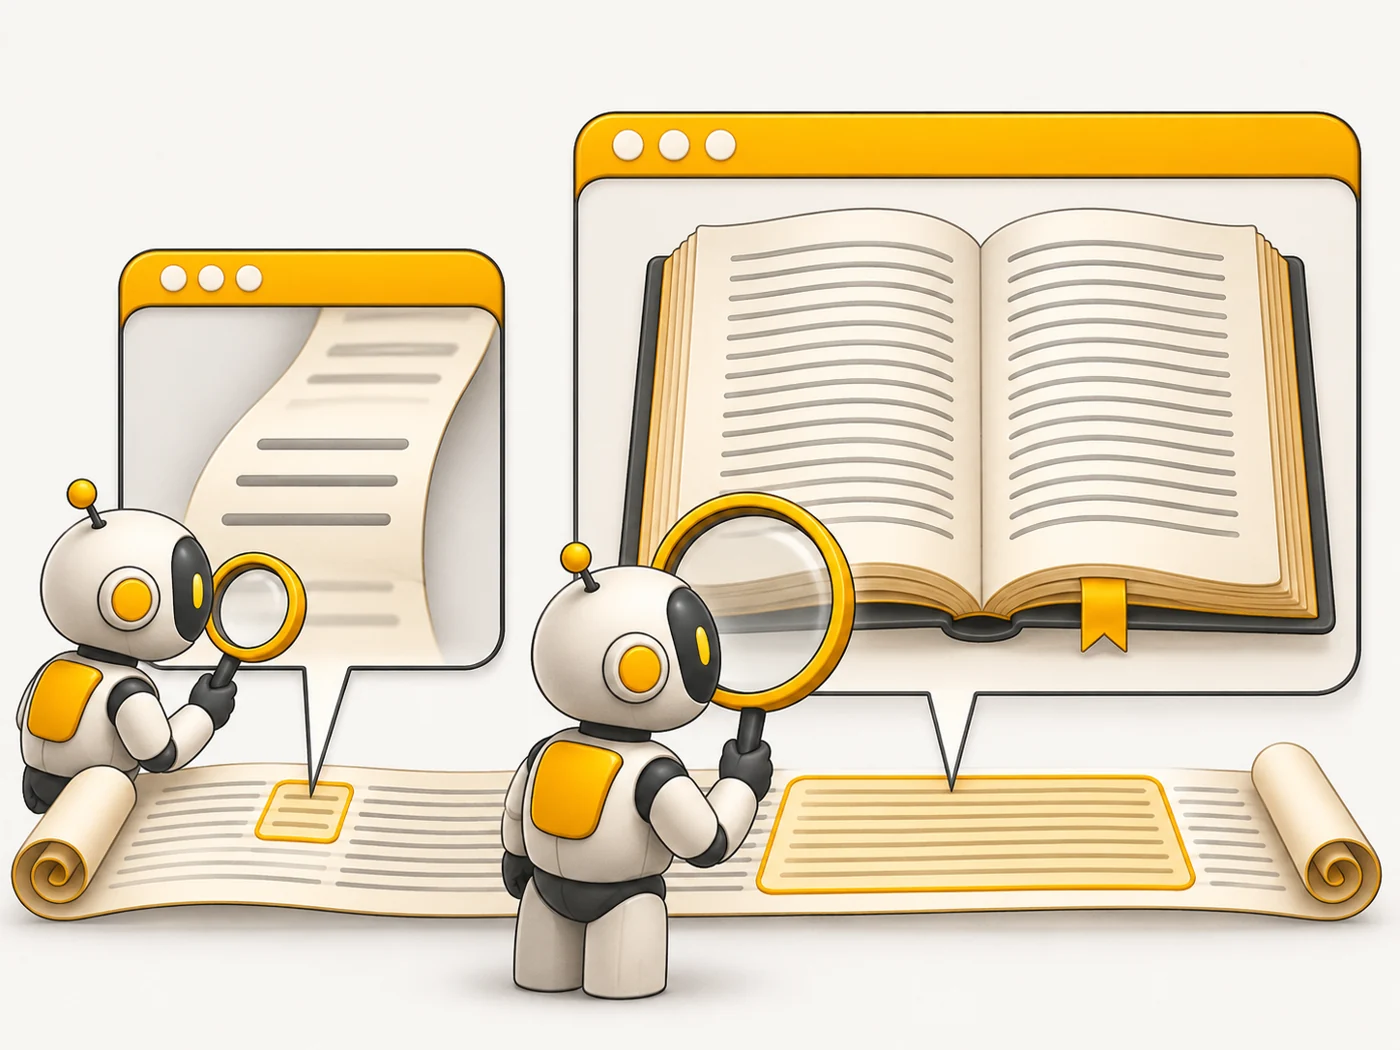
- Todo lo que el modelo debe tener en cuenta se junta en una larga cinta de tokens.
- Si la cinta es más larga que la ventana, las partes más antiguas se recortan o se resumen.
- El modelo responde teniendo en cuenta solo lo que cabe en la ventana.
- Los modelos actuales tienen ventanas de decenas de miles hasta un millón de tokens o más.
- Cuanto más llena está la ventana, más tarda y más cuesta procesar la petición.
Dónde lo verás
El tamaño de la ventana de contexto aparece en las descripciones de modelos y planes: «128K», «200K», «1M tokens». Lo notas cuando subes al chatbot un PDF grande o el código de todo un proyecto, o cuando una conversación larga de repente «olvida» lo acordado al principio.
¿Importa al elegir?
Sí, si trabajas con documentos grandes: apuntes, libros, código. Entonces elige un modelo con una ventana grande. Mi truco para conversaciones largas: de vez en cuando pide al bot un resumen breve de lo acordado y empieza un chat nuevo con ese resumen.
Mitos
- Mito: Con una ventana grande, el bot lo recuerda todo a la perfección. En realidad: Incluso dentro de la ventana, el modelo puede pasar por alto un detalle de la mitad de un texto largo.
- Mito: La ventana de contexto es la memoria a largo plazo del bot. En realidad: No, es solo la conversación actual. La «memoria» a largo plazo es una función aparte de algunos servicios.
Preguntas frecuentes
¿Cuánto texto caben en 128 000 tokens?
Más o menos un libro corto: cientos de páginas, según el idioma.
¿Por qué el bot olvidó lo que dije al principio?
Lo más probable es que la conversación superara la ventana y se recortaran los mensajes antiguos.
¿Tiene una ventana grande un modelo local en el móvil?
Normalmente menor que los de la nube: le falta memoria del dispositivo.
Términos relacionados
Token, Modelo de lenguaje grande, Chatbot, Generación aumentada por recuperación