
Cuantización del modelo: cómo comprimir la IA para que quepa en el móvil
La cuantización es una forma de reducir el tamaño de una red neuronal guardando sus parámetros con números menos precisos (por ejemplo, 4 bits en lugar de 16). El modelo se vuelve más pequeño y rápido y pierde poca calidad.
En pocas palabras
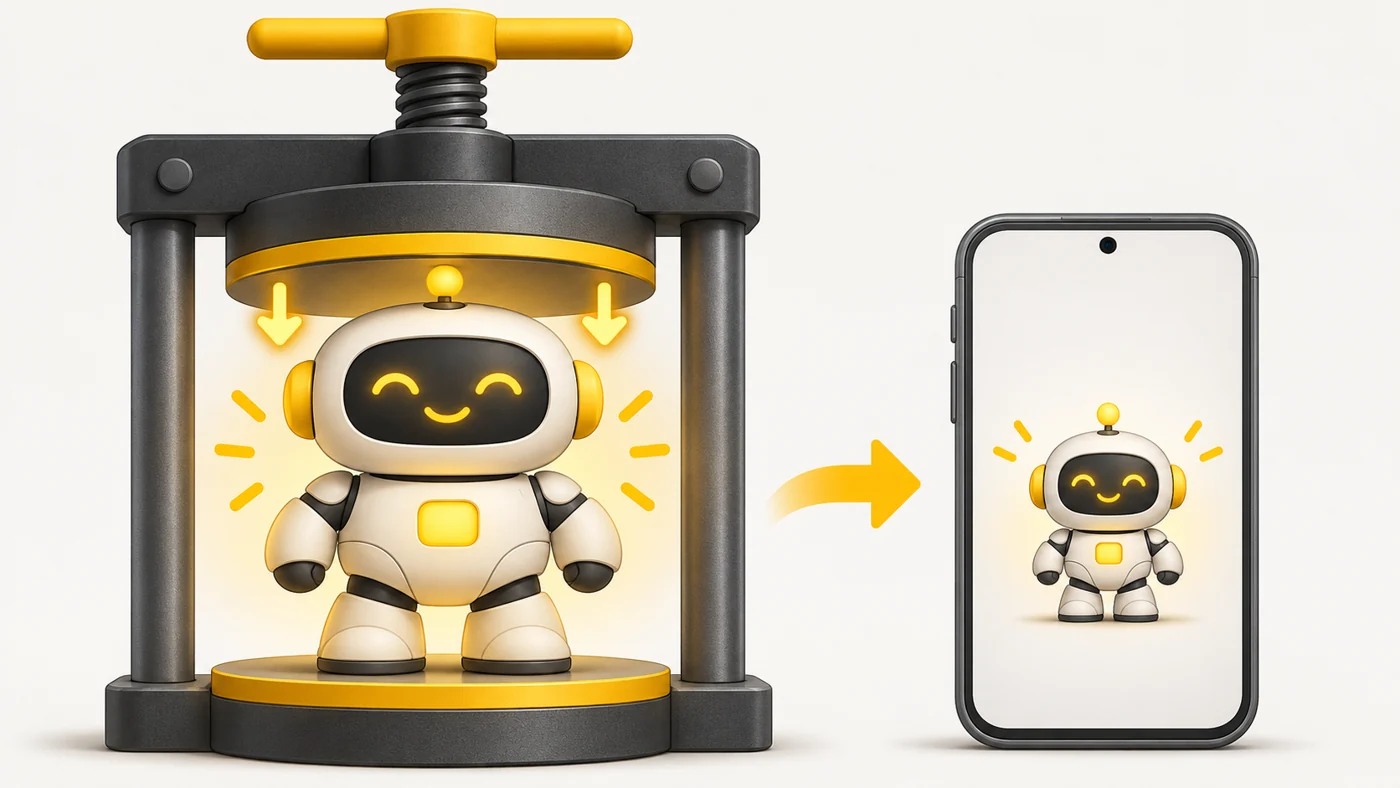
Imagina una foto de 50 megapíxeles que tienes que mandar por mensajería. La comprimes: el archivo es decenas de veces más pequeño y en la pantalla del móvil casi no se nota. La cuantización hace lo mismo con los parámetros del modelo: redondea los números, el modelo «adelgaza» varias veces y responde casi igual.
Cómo funciona
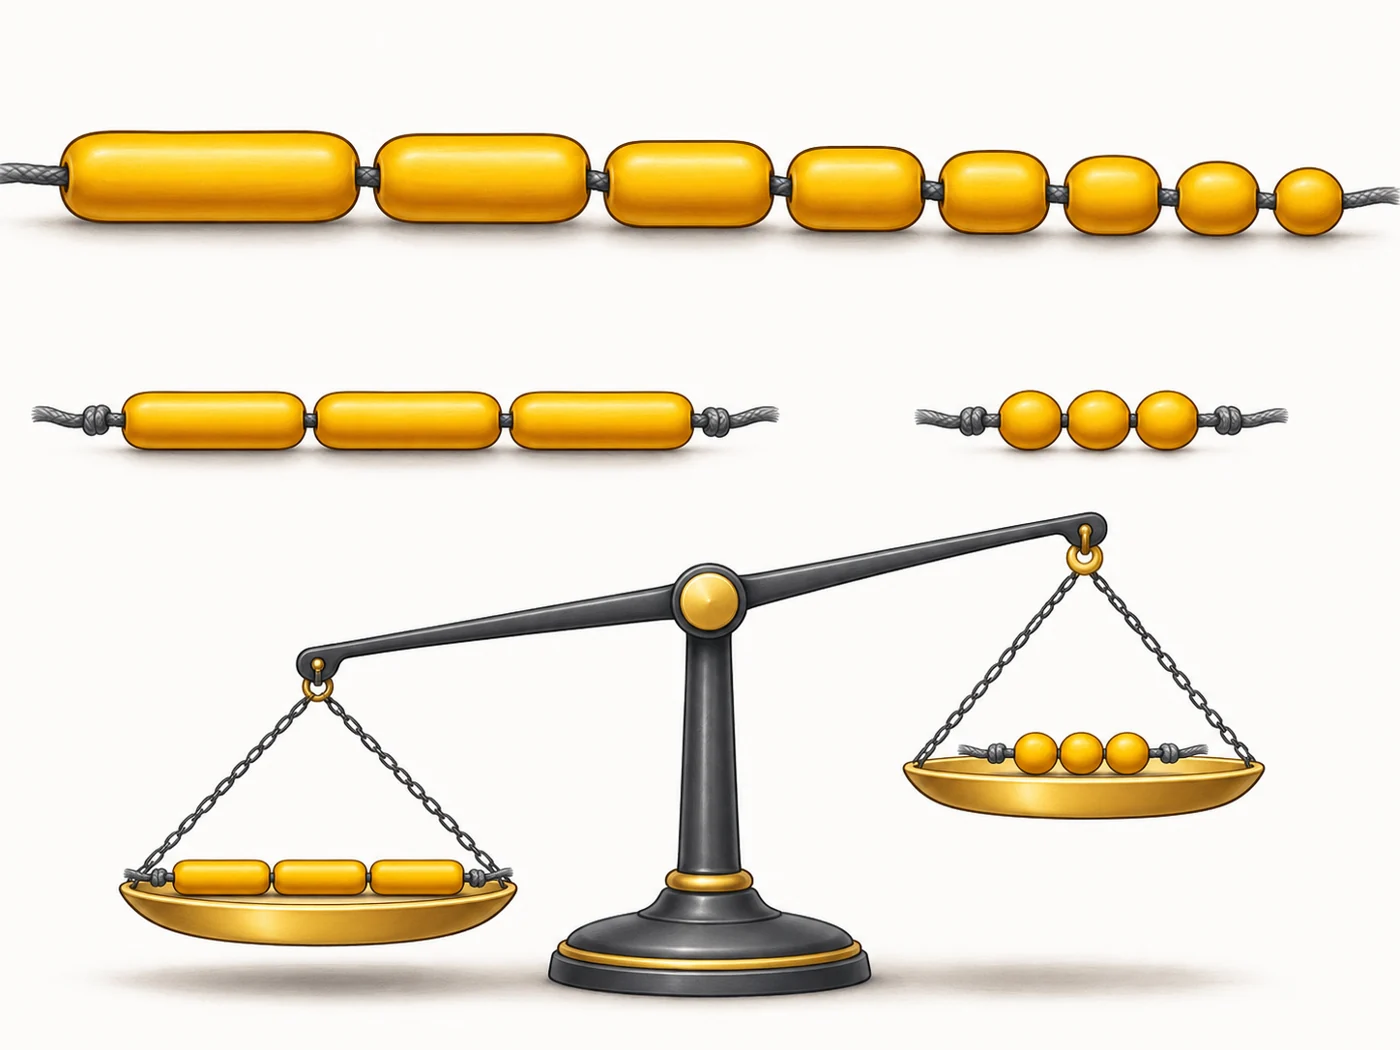
- Los parámetros de un modelo suelen guardarse como números de 16 o 32 bits.
- Al cuantizar, se redondean a 8, 4 o incluso menos bits.
- El modelo ocupa varias veces menos memoria y va más rápido en una NPU o tarjeta gráfica.
- Los métodos más listos redondean con cabeza para que los números más importantes conserven precisión.
- Cuanto más fuerte la compresión, más puede notarse la caída de calidad.
Dónde lo verás
Los modelos cuantizados son la base de la IA en el dispositivo: móviles y portátiles ejecutan versiones comprimidas. Los aficionados que ejecutan modelos en su ordenador ven etiquetas como Q4, Q8, INT4 o GGUF: indican el nivel de cuantización y el formato del archivo.
¿Importa al elegir?
Para un usuario normal es trabajo invisible del fabricante. Pero si ejecutas modelos locales, sí importa: una versión de 4 bits da un equilibrio sensato entre calidad y tamaño. También explica por qué el soporte de INT4 e INT8 en el procesador neuronal es una característica útil.
Mitos
- Mito: Un modelo cuantizado es otro modelo distinto y peor. En realidad: Es el mismo modelo con números menos precisos. En la mayoría de tareas la diferencia es pequeña.
- Mito: Se puede comprimir a 1 bit sin perder nada. En realidad: Cuanto más fuerte la compresión, más calidad se pierde: no hay milagros.
Preguntas frecuentes
¿Qué significa Q4 en el nombre del archivo de un modelo?
Que los parámetros se guardan con unos cuatro bits: una de las opciones más populares.
¿Puedo cuantizar un modelo yo mismo?
Sí, hay herramientas listas para modelos abiertos.
¿Por qué a los móviles les gustan INT8 e INT4?
Porque la NPU procesa esos números cortos más rápido y gastando menos energía.
Términos relacionados
Parámetros del modelo, IA en el dispositivo, Procesador neuronal (NPU), Modelos abiertos