
Model multimodalny: AI, która widzi, słyszy i czyta
Model multimodalny to AI, która pracuje z kilkoma typami danych naraz: tekstem, obrazami, dźwiękiem, wideo. Możesz pokazać jej zdjęcie i zapytać głosem, a ona odpowie tekstem lub głosem.
Prostymi słowami
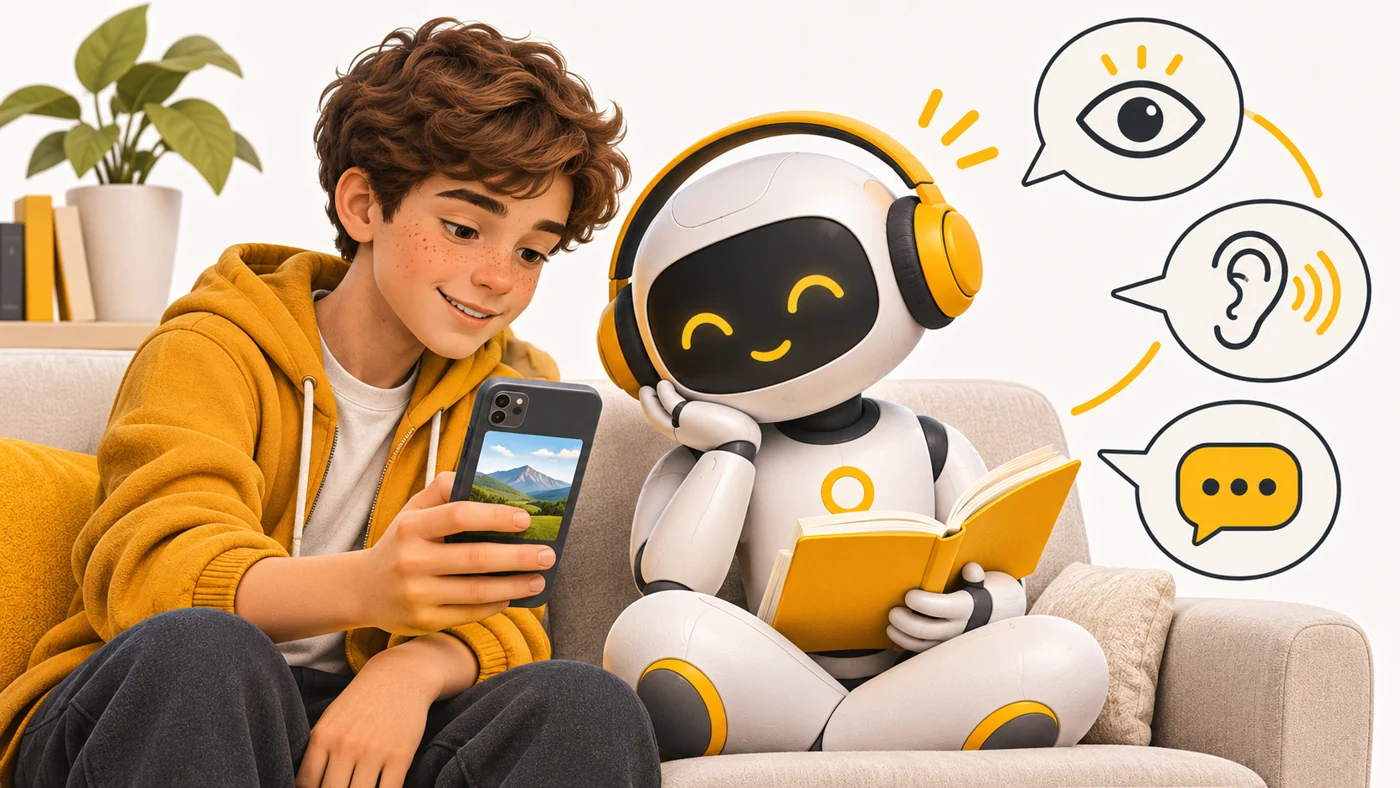
Pierwsze chatboty były jak korespondencyjny znajomy: tylko tekst. Model multimodalny jest jak przyjaciel, który siedzi obok: pokazujesz mu zdjęcie, puszczasz piosenkę, pokazujesz palcem schemat - i rozumie wszystko razem. „Modalność” to po prostu typ informacji: tekst, obraz, dźwięk.
Jak to działa
- Każdy typ danych zamienia się na liczby: tekst na tokeny, zdjęcie na małe fragmenty („łatki”), dźwięk na kawałki widma.
- Model uczono na parach danych: zdjęcia z opisami, wideo z napisami, dźwięk z tekstem.
- Dlatego „rozumie”, jak słowa łączą się z tym, co widać i słychać.
- Możesz łączyć typy w jednym zapytaniu: „co jest nie tak z moim rozwiązaniem?” plus zdjęcie zeszytu.
- Niektóre modele odpowiadają nie tylko tekstem, ale też głosem lub obrazem.
Gdzie to zobaczysz
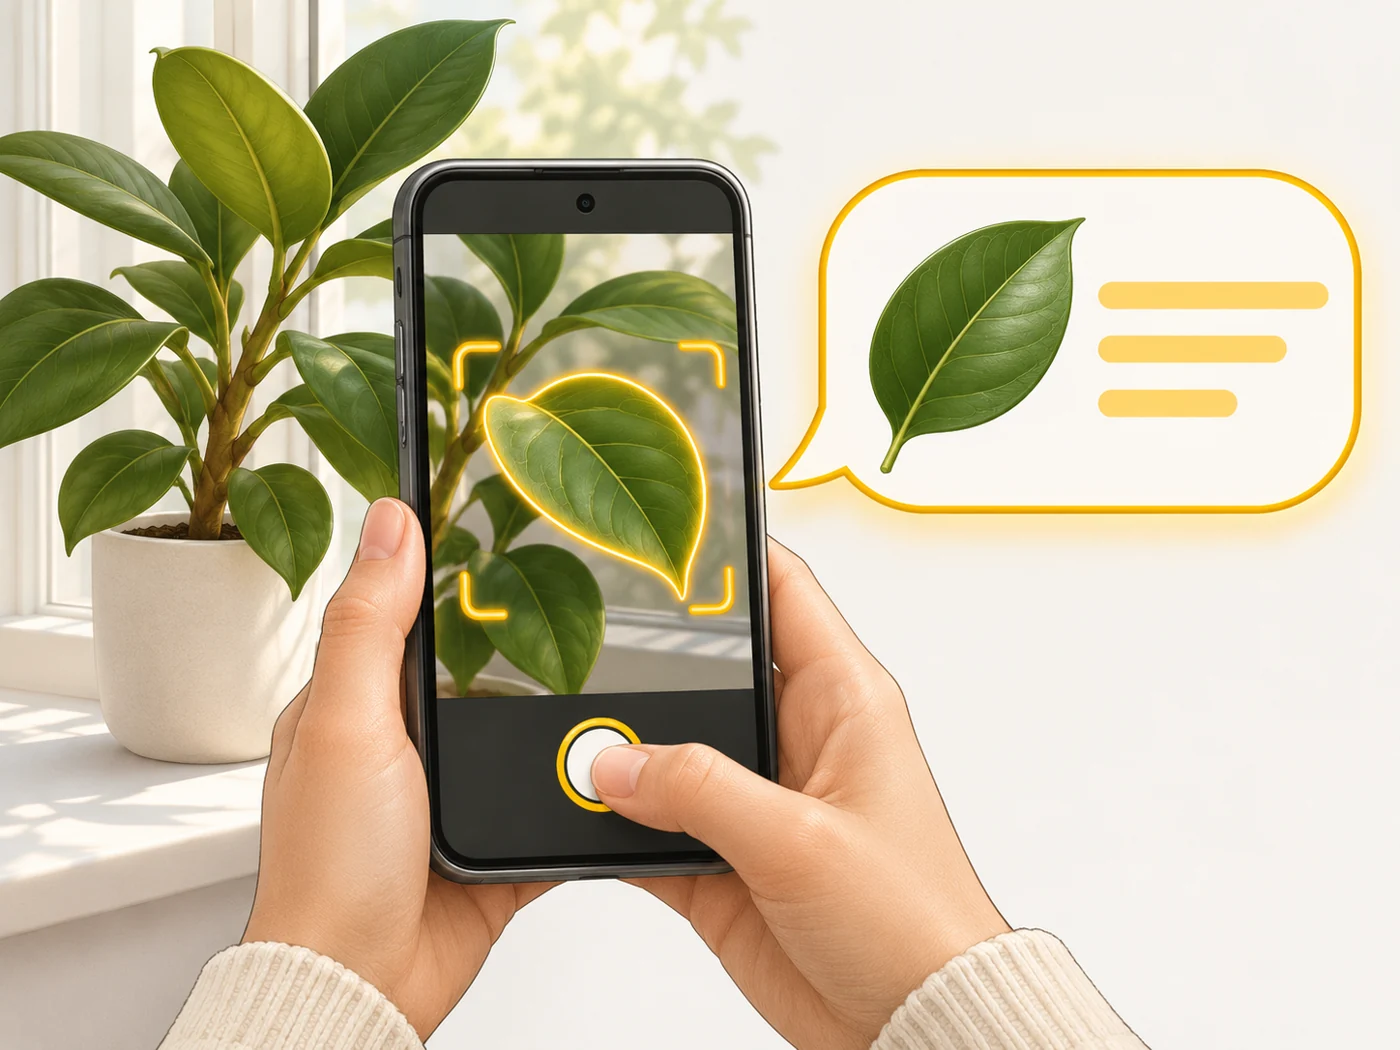
Prawie wszyscy czołowi asystenci AI są już multimodalni: możesz sfotografować menu i poprosić o tłumaczenie, skierować aparat na roślinę i zapytać o nazwę, porozmawiać głosem. W smartfonach to funkcje w rodzaju wyszukiwania zakreśleniem (Circle to Search) i rozmów z asystentem przez aparat.
Czy to ważne przy wyborze
Tak, bo to jedna z najbardziej przydatnych rzeczy, jakie AI robi na co dzień. Do tego liczą się dobry aparat, mikrofony i szybki internet albo mocne NPU. Ale pamiętaj: pokazując modelowi zdjęcie, wysyłasz je na serwer. Dokumentów i cudzych twarzy nie fotografowałbym dla AI bez potrzeby.
Mity
- Mit: Model „widzi” tak samo jak człowiek. W rzeczywistości: Analizuje piksele według wyuczonych prawidłowości i może się pomylić tam, gdzie człowiek by się nie pomylił.
- Mit: Multimodalność dotyczy tylko zdjęć. W rzeczywistości: To także dźwięk, wideo, dokumenty, wykresy, a nawet dane z czujników.
Częste pytania
Czy model przeczyta pismo odręczne?
Przeważnie tak, jeśli pismo jest czytelne, a zdjęcie ostre.
Czy to działa bez internetu?
Proste funkcje na flagowcach tak, złożone - głównie przez chmurę.
Czy model rozumie wideo?
Nowoczesne modele potrafią analizować wideo, dzieląc je na klatki i dźwięk.
Powiązane pojęcia
Duży model językowy, Widzenie komputerowe, Rozpoznawanie mowy, Modele „wizja-język-działanie”