
Modele VLA: AI, która widzi, rozumie polecenie i steruje robotem
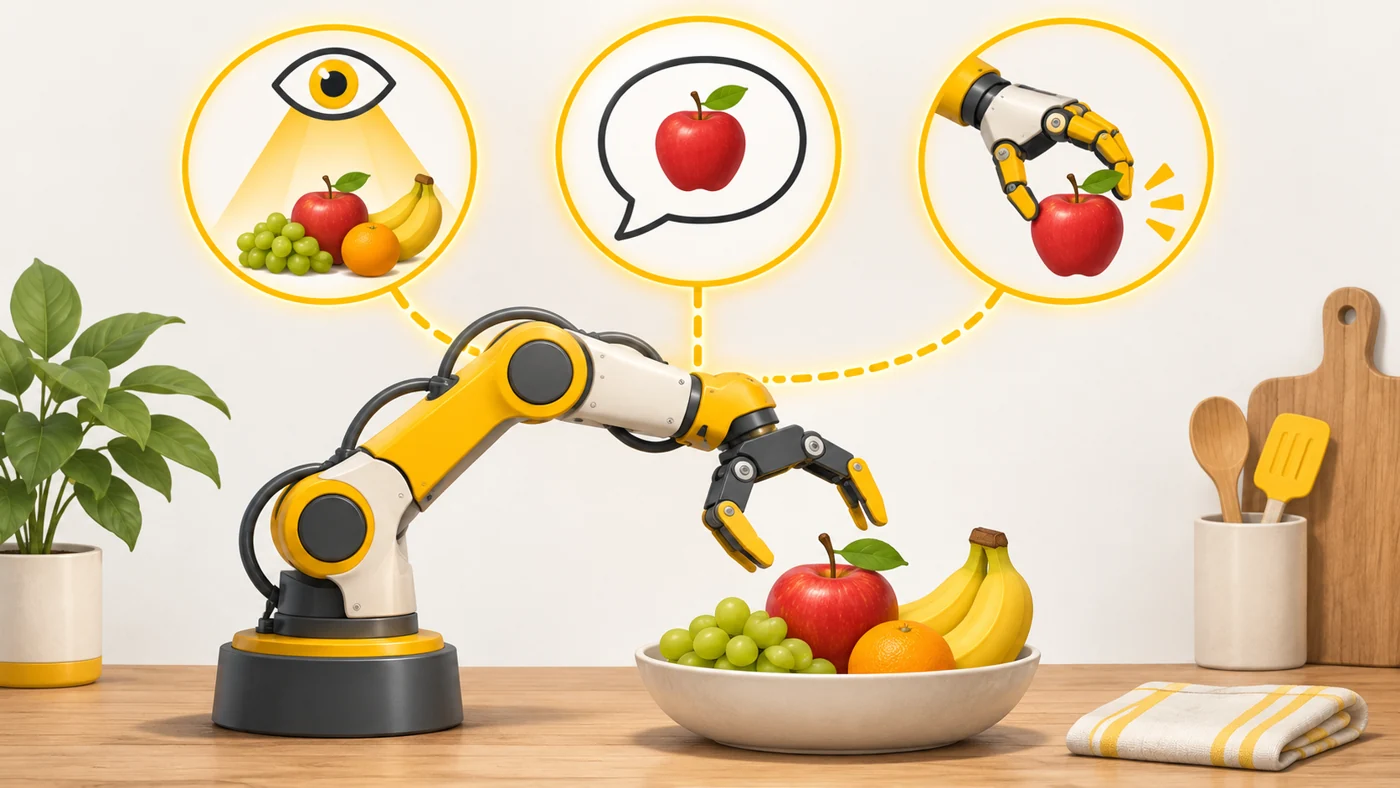
Model „wizja-język-działanie” (VLA, Vision-Language-Action) to sieć neuronowa, która jednocześnie analizuje obraz z kamer, rozumie polecenie tekstowe lub głosowe i podaje konkretne działania dla robota: jak ruszyć ramieniem, chwytakiem lub kołami.
Prostymi słowami
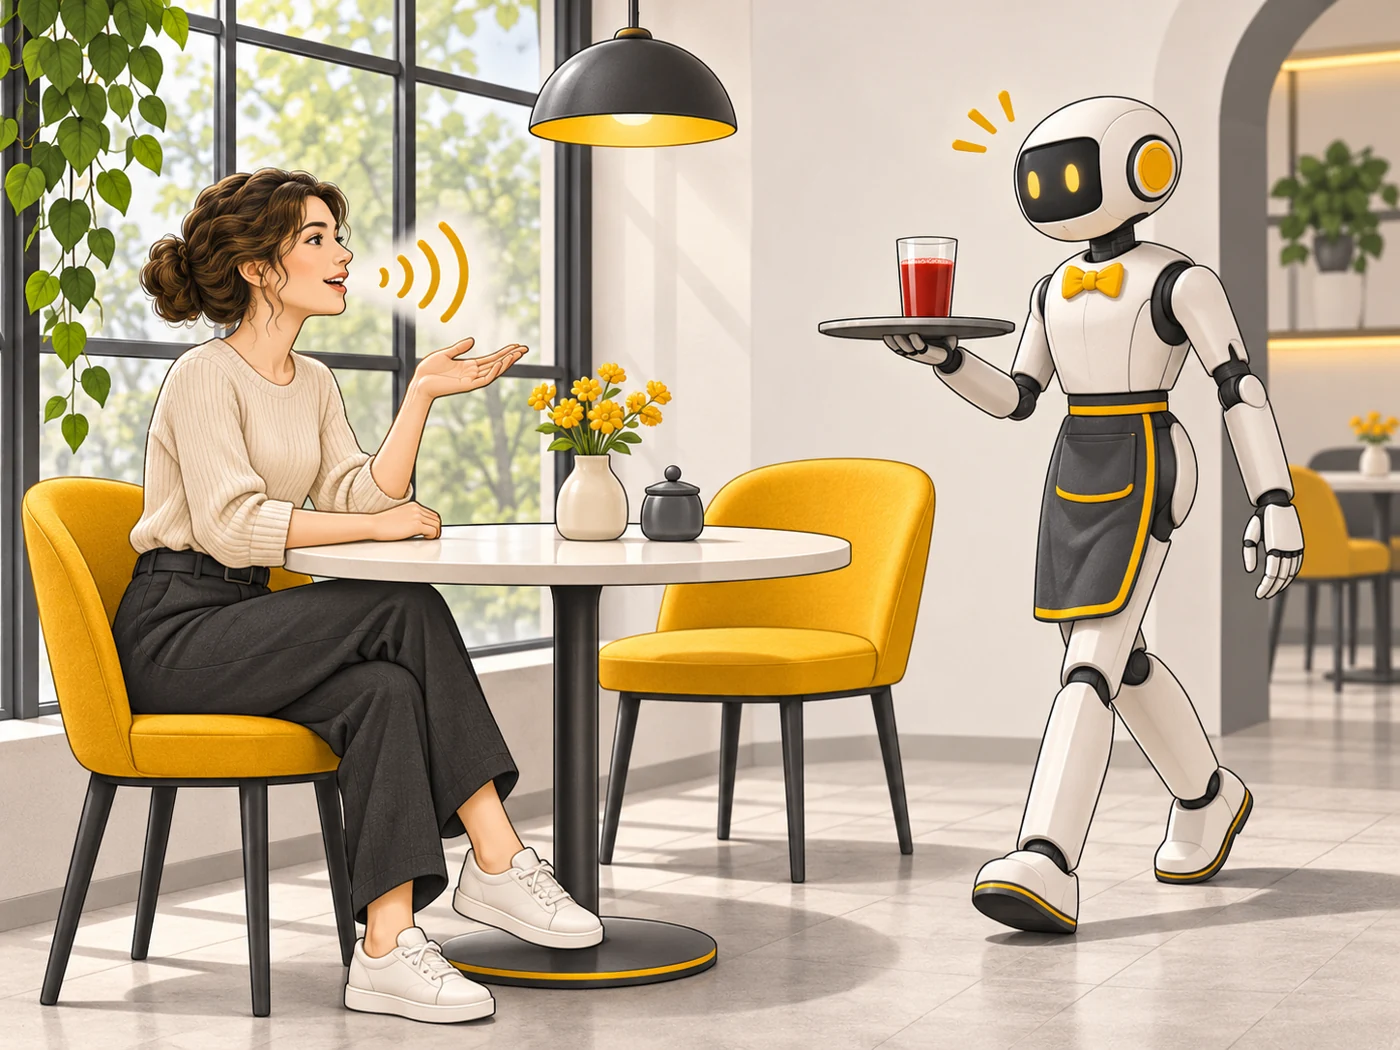
Wyobraź sobie kelnera, któremu mówisz: „Proszę przynieść ten czerwony sok przy oknie”. Musi zobaczyć stół, zrozumieć słowa i wykonać właściwe ruchy. Model VLA robi te trzy rzeczy razem: oczy (vision), rozumienie słów (language) i ręce (action) w jednym „mózgu”.
Jak to działa
- Kamery robota przekazują obraz do modelu.
- Model dostaje polecenie człowieka w zwykłym języku.
- Zestawia słowa z tym, co widzi: „jabłko” to ten czerwony przedmiot.
- Na wyjściu model generuje nie tekst, tylko sekwencję ruchów - tak jak model językowy generuje słowa.
- Robot wykonuje ruchy, kamera widzi nowy stan - i pętla się powtarza.
Gdzie to zobaczysz
W laboratoriach badawczych i firmach rozwijających humanoidy i roboty-pomocników. Takie modele trenuje się na dużych zbiorach nagrań robotów i na filmach z ludźmi. To jedno z głównych podejść we współczesnej robotyce.
Czy to ważne przy wyborze
Na zakupy na razie nie wpływa. Ale ten termin wyjaśnia, dlaczego postęp w robotach nagle przyspieszył: te same idee, które uczyniły chatboty mądrymi, stosuje się teraz do ruchu. Jeśli interesuje cię robotyka jako zawód - warto śledzić ten temat.
Mity
- Mit: Model VLA to po prostu chatbot w robocie. W rzeczywistości: Nie podaje tekstu, tylko polecenia dla silników, i uczy się na danych o ruchu.
- Mit: Jeden model umie już wszystko. W rzeczywistości: Na razie roboty z VLA dobrze wykonują znane typy zadań, ale w nowych warunkach często się mylą.
Częste pytania
Czym VLA różni się od modelu multimodalnego?
Multimodalny odpowiada tekstem, VLA - ruchami robota.
Na czym trenuje się VLA?
Na nagraniach robotów wykonujących zadania, demonstracjach ludzi i filmach.
Czy VLA działa na samym robocie?
Często tak, na komputerze pokładowym, bo opóźnienia przez internet przeszkadzają w ruchu.
Powiązane pojęcia
Ucieleśniona AI, Model multimodalny, Widzenie komputerowe, Robot humanoidalny