VLA-моделі: ШІ, який бачить, розуміє команду і керує роботом
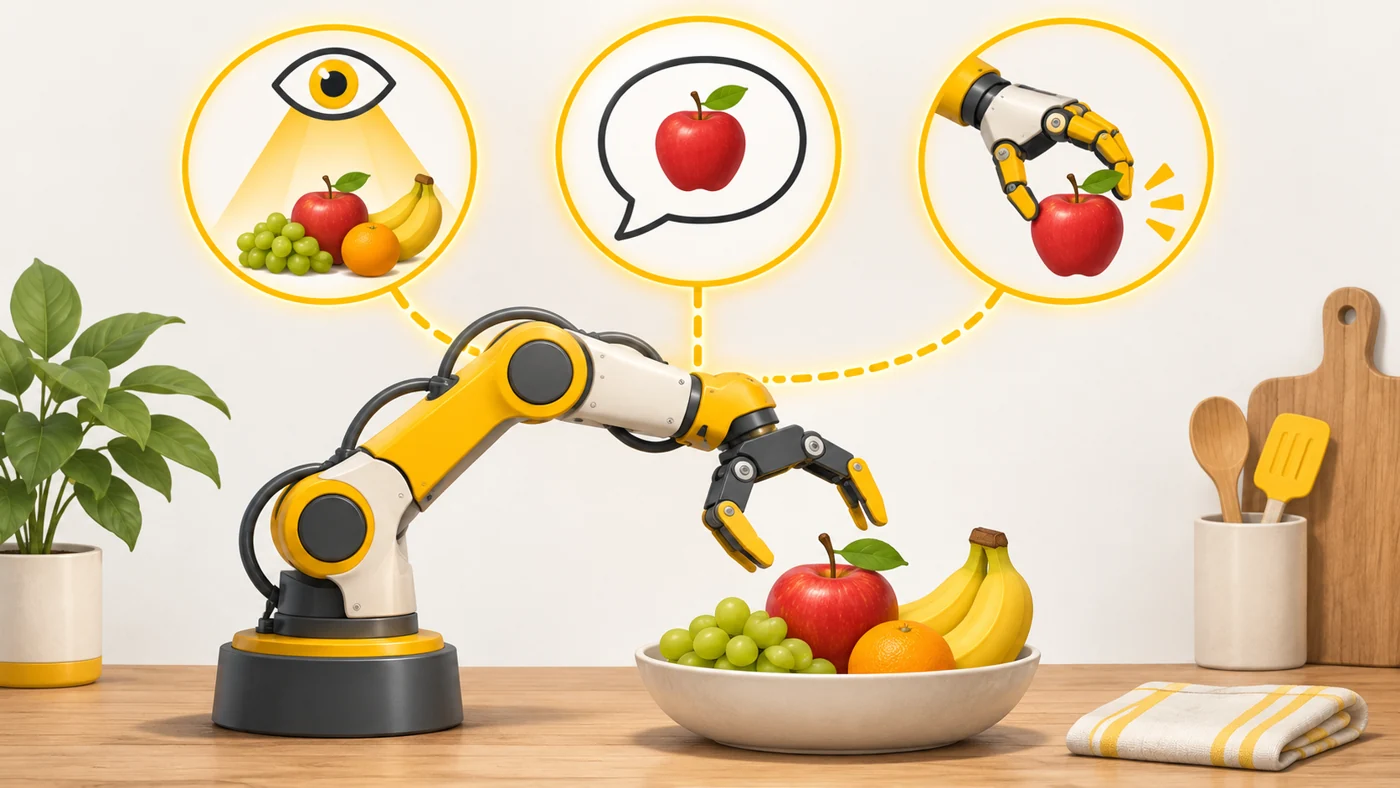
Модель «бачення-мова-дія» (VLA, Vision-Language-Action) - це нейромережа, яка одночасно аналізує зображення з камер, розуміє текстову чи голосову команду і видає конкретні дії для робота: як рухати руку, захоплювач чи колеса.
Простими словами
Уяви офіціанта, якому кажуть: «Принесіть, будь ласка, той червоний сік біля вікна». Він має побачити стіл, зрозуміти слова і зробити правильні рухи. VLA-модель робить ці три речі разом: очі (vision), розуміння слів (language) і руки (action) в одному «мозку».
Як це працює
- Камери робота передають зображення в модель.
- Модель отримує команду людини звичайною мовою.
- Вона зіставляє слова з тим, що бачить: «яблуко» - ось цей червоний предмет.
- На виході модель генерує не текст, а послідовність рухів - як мовна модель генерує слова.
- Робот виконує рухи, камера бачить новий стан - і цикл повторюється.
Де ти це побачиш
У дослідницьких лабораторіях і компаніях, що розробляють гуманоїдів і роботів-помічників. Такі моделі навчають на великих наборах записів роботів і на відео з людьми. Це один з основних підходів у сучасній робототехніці.
Чи важливо це при виборі
На покупку поки не впливає. Але цей термін пояснює, чому прогрес у роботах раптом пришвидшився: ті самі ідеї, що зробили чат-ботів розумними, тепер застосовують до рухів. Якщо цікавишся робототехнікою як професією - варто стежити за цією темою.
Міфи
- Міф: VLA-модель - це просто чат-бот у роботі. Насправді: Вона видає не текст, а команди для моторів, і вчиться на даних рухів.
- Міф: Одна модель уже вміє все. Насправді: Поки що роботи на VLA добре виконують знайомі типи завдань, але в нових умовах часто помиляються.
Часті питання
Чим VLA відрізняється від мультимодальної моделі?
Мультимодальна відповідає текстом, VLA - рухами робота.
На чому навчають VLA?
На записах роботів, які виконують завдання, демонстраціях людей і відео.
Чи працює VLA на самому роботі?
Часто так, на бортовому комп'ютері, бо затримка через інтернет заважає рухам.
Пов'язані терміни
Втілений ШІ, Мультимодальна модель, Комп'ютерний зір, Гуманоїдний робот