
Modelo multimodal: la IA que ve, oye y lee
Un modelo multimodal es una IA que trabaja con varios tipos de datos a la vez: texto, imágenes, sonido y vídeo. Puedes enseñarle una foto y preguntarle en voz alta, y te responde con texto o con voz.
En pocas palabras
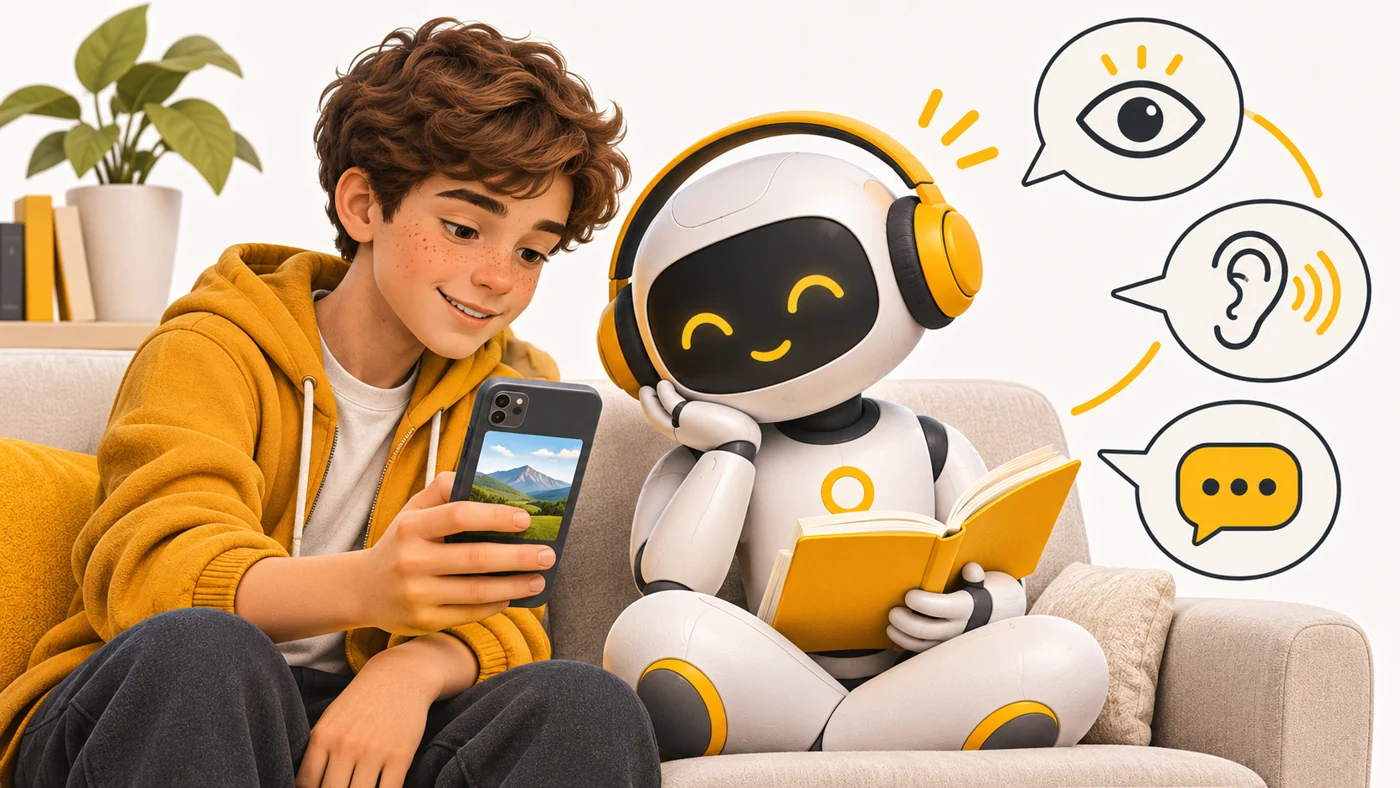
Los primeros chatbots eran como un amigo por correspondencia: solo texto. Un modelo multimodal es como un amigo sentado a tu lado: le enseñas una foto, le pones una canción, señalas un esquema con el dedo... y lo entiende todo junto. Una «modalidad» es simplemente un tipo de información: texto, imagen, sonido.
Cómo funciona
- Cada tipo de datos se convierte en números: el texto en tokens, la foto en pequeños fragmentos («parches»), el sonido en trocitos de espectro.
- El modelo se entrenó con pares de datos: fotos con descripciones, vídeos con subtítulos, audio con texto.
- Por eso «entiende» cómo se relacionan las palabras con lo que se ve y se oye.
- Puedes combinar tipos en una sola petición: «¿qué falla en mi solución?» más una foto del cuaderno.
- Algunos modelos responden no solo con texto, también con voz o con una imagen.
Dónde lo verás
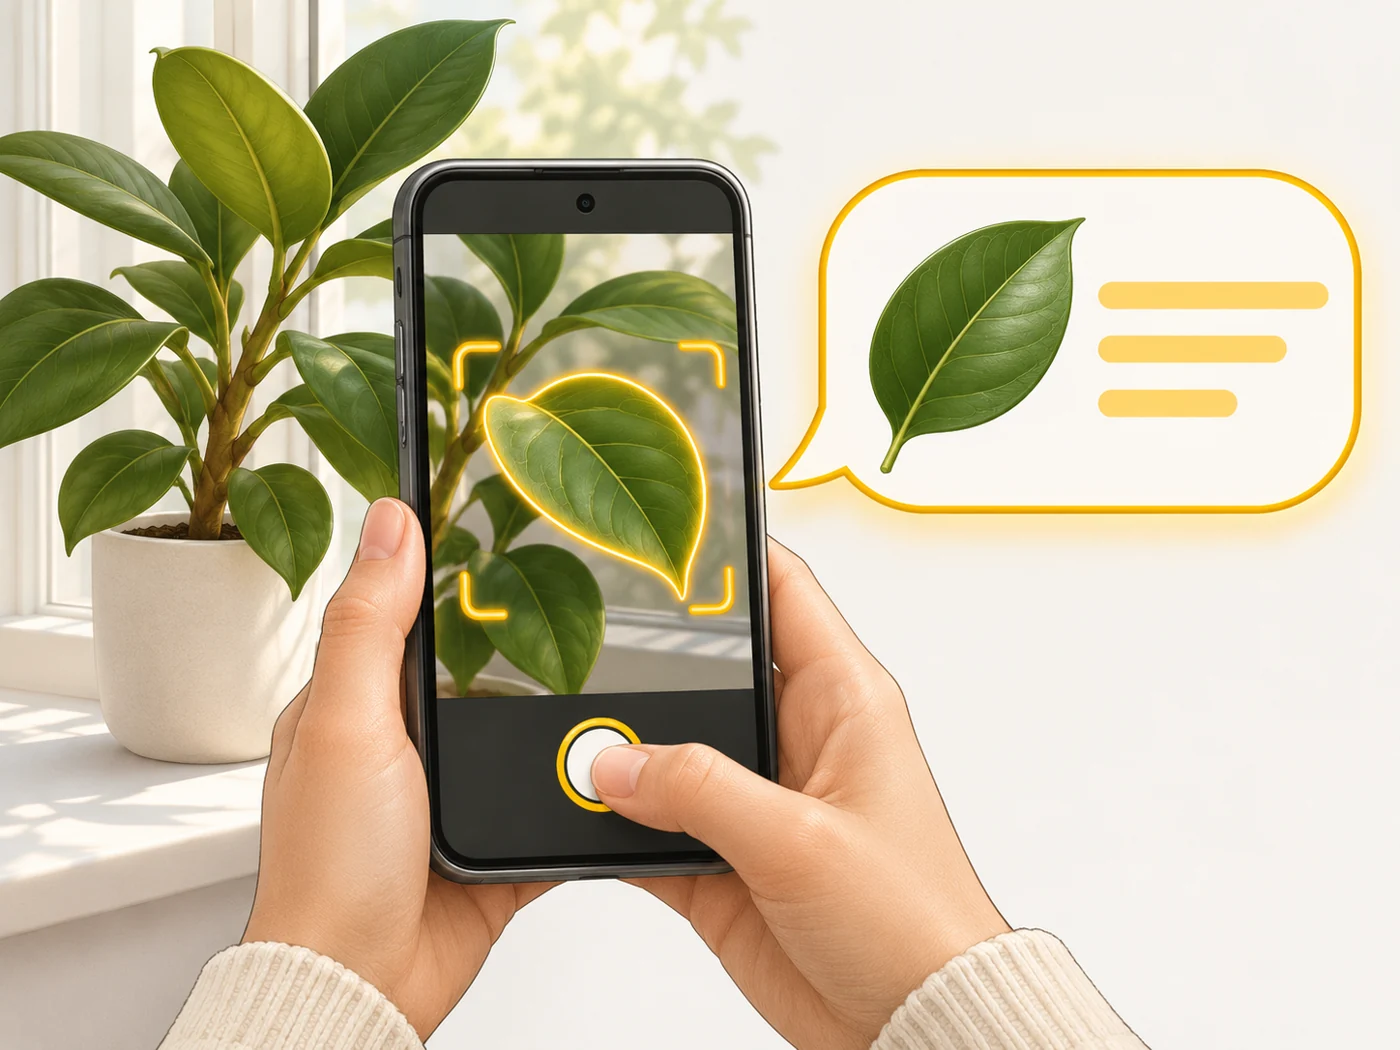
Casi todos los asistentes de IA punteros ya son multimodales: puedes fotografiar un menú y pedir la traducción, apuntar la cámara a una planta y preguntar su nombre o hablar por voz. En los móviles son funciones como Rodea para buscar (Circle to Search) y conversar con el asistente a través de la cámara.
¿Importa al elegir?
Sí, porque es una de las cosas más útiles de la IA en el día a día. Para ello importan una buena cámara, buenos micrófonos y un internet rápido o una NPU potente. Pero recuerda: al enseñarle una foto al modelo, la envías a un servidor. Yo no fotografiaría documentos ni caras ajenas para la IA si no hace falta.
Mitos
- Mito: El modelo «ve» igual que una persona. En realidad: Analiza píxeles según patrones aprendidos y puede fallar donde una persona no fallaría.
- Mito: Lo multimodal solo va de fotos. En realidad: También incluye sonido, vídeo, documentos, gráficos e incluso datos de sensores.
Preguntas frecuentes
¿Puede el modelo leer texto escrito a mano?
Casi siempre sí, si la letra es legible y la foto está nítida.
¿Funciona sin internet?
Las funciones sencillas, en la gama alta sí; las complejas, sobre todo en la nube.
¿Entiende el modelo un vídeo?
Los modelos actuales pueden analizar vídeo dividiéndolo en fotogramas y sonido.
Términos relacionados
Modelo de lenguaje grande, Visión artificial, Reconocimiento de voz, Modelos visión-lenguaje-acción