
Modelos VLA: la IA que ve, entiende una orden y controla un robot
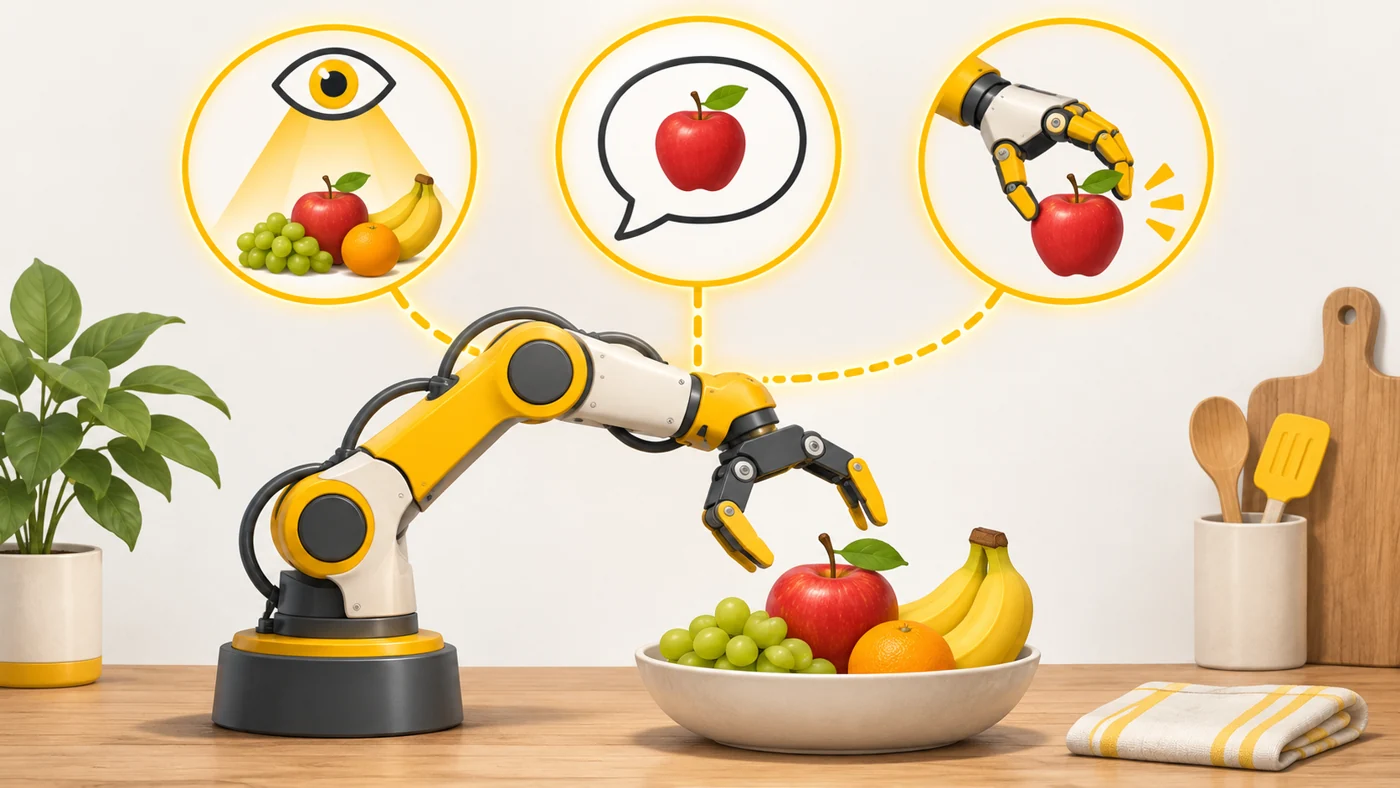
Un modelo visión-lenguaje-acción (VLA, Vision-Language-Action) es una red neuronal que, a la vez, analiza las imágenes de las cámaras, entiende una orden de texto o de voz y genera acciones concretas para un robot: cómo mover el brazo, la pinza o las ruedas.
En pocas palabras
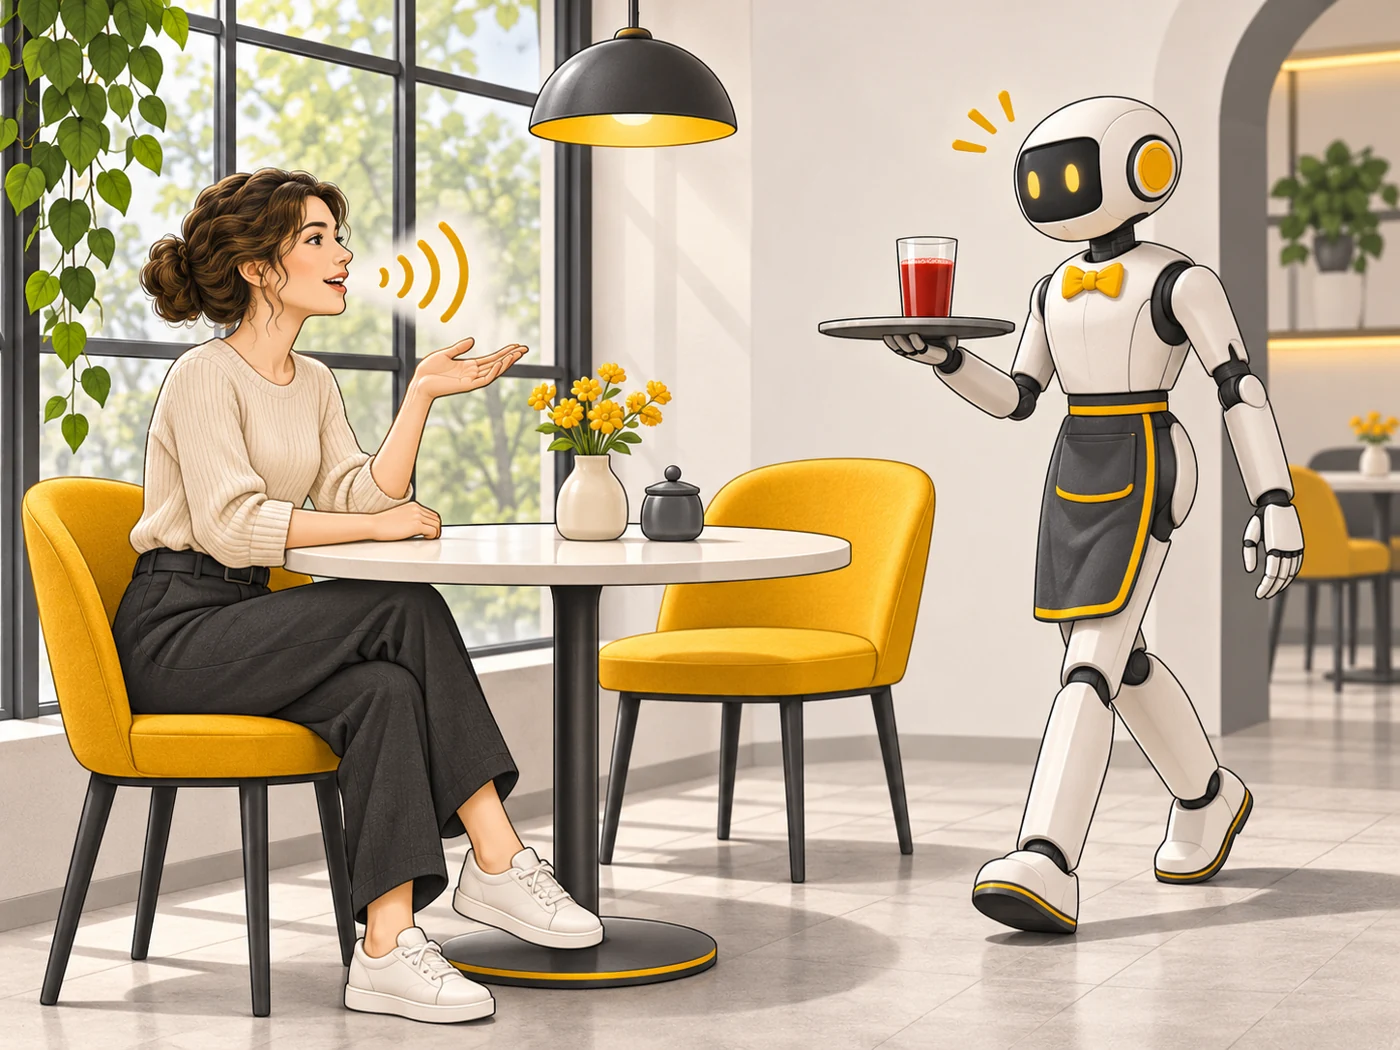
Imagina a un camarero al que le dicen: «¿Me trae, por favor, ese zumo rojo de al lado de la ventana?». Tiene que ver la mesa, entender las palabras y hacer los movimientos correctos. Un modelo VLA hace esas tres cosas juntas: ojos (vision), comprensión de palabras (language) y manos (action) en un solo «cerebro».
Cómo funciona
- Las cámaras del robot envían imágenes al modelo.
- El modelo recibe la orden de una persona en lenguaje normal.
- Relaciona las palabras con lo que ve: «manzana» es este objeto rojo.
- En lugar de texto, el modelo genera una secuencia de movimientos, igual que un modelo de lenguaje genera palabras.
- El robot se mueve, la cámara ve la nueva situación y el ciclo se repite.
Dónde lo verás
En laboratorios de investigación y empresas que desarrollan humanoides y robots ayudantes. Estos modelos se entrenan con grandes colecciones de grabaciones de robots y vídeos de personas. Es uno de los enfoques principales de la robótica actual.
¿Importa al elegir?
De momento no influye en lo que compras. Pero el término explica por qué el progreso de los robots se ha acelerado de repente: las mismas ideas que hicieron listos a los chatbots se aplican ahora al movimiento. Si te interesa la robótica como profesión, merece la pena seguir este tema.
Mitos
- Mito: Un modelo VLA es solo un chatbot dentro de un robot. En realidad: No genera texto, sino órdenes para los motores, y aprende con datos de movimiento.
- Mito: Un solo modelo ya lo sabe hacer todo. En realidad: Por ahora, los robots con VLA hacen bien tareas de tipos conocidos, pero en condiciones nuevas a menudo fallan.
Preguntas frecuentes
¿En qué se diferencia un VLA de un modelo multimodal?
El multimodal responde con texto; el VLA, con movimientos del robot.
¿Con qué se entrenan los VLA?
Con grabaciones de robots haciendo tareas, demostraciones de personas y vídeos.
¿Funciona el VLA en el propio robot?
A menudo sí, en un ordenador de a bordo, porque el retraso de internet estorba al movimiento.
Términos relacionados
IA corporizada, Modelo multimodal, Visión artificial, Robot humanoide