
Entrenamiento e inferencia: las dos etapas de la vida de una red neuronal
El entrenamiento (training) es la etapa en la que una red neuronal aprende de enormes conjuntos de datos. La inferencia (inference) es la etapa de uso de un modelo ya entrenado: recibe una petición y da una respuesta.
En pocas palabras
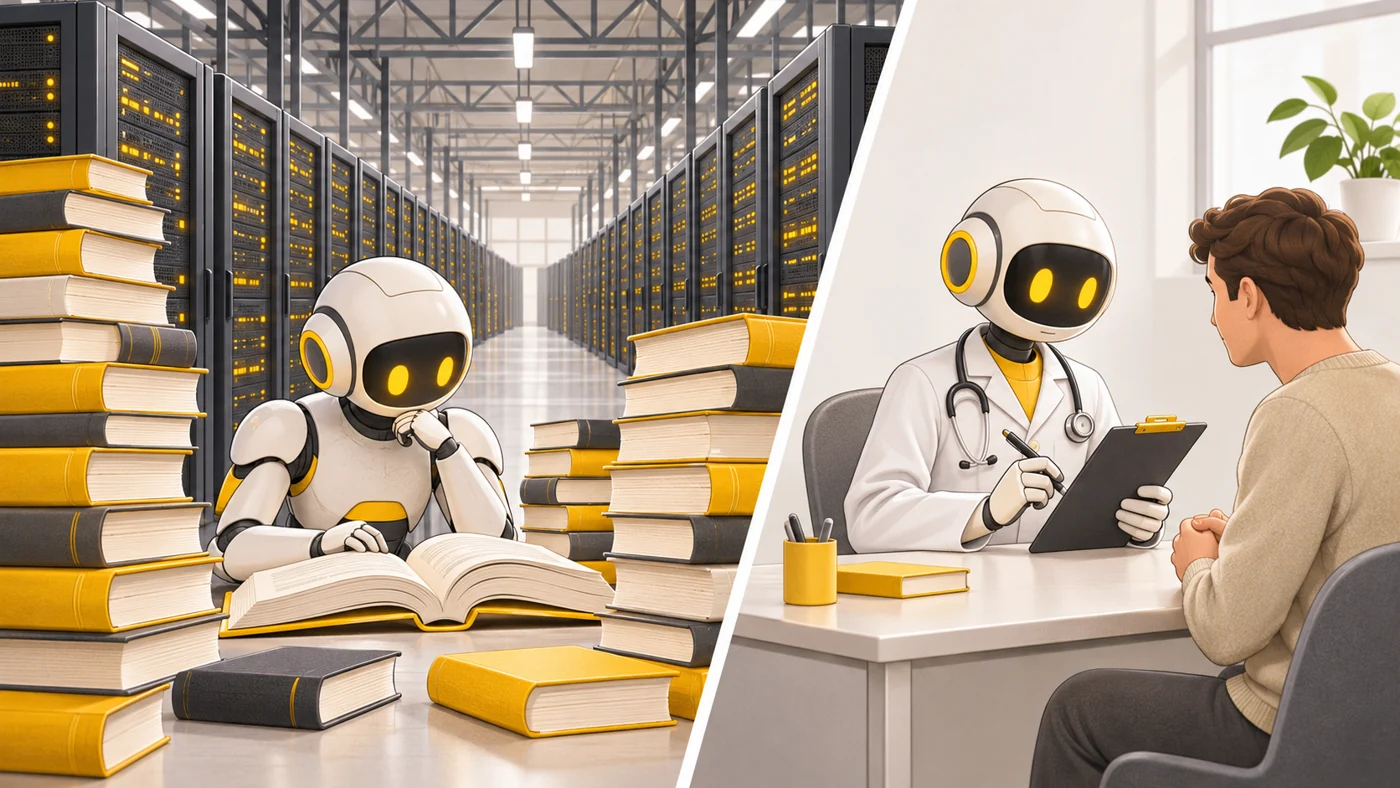
El entrenamiento son los años de instituto y universidad: largos, caros, con montañas de libros. La inferencia es el trabajo después de estudiar: una médica mira al paciente y da un diagnóstico en un minuto. No vuelve a estudiar medicina cada vez, usa lo que ya sabe.
Cómo funciona
- Durante el entrenamiento, el modelo pasa por los datos millones de veces y se ajustan sus parámetros.
- Se hace en centros de datos con miles de aceleradores, a veces durante meses.
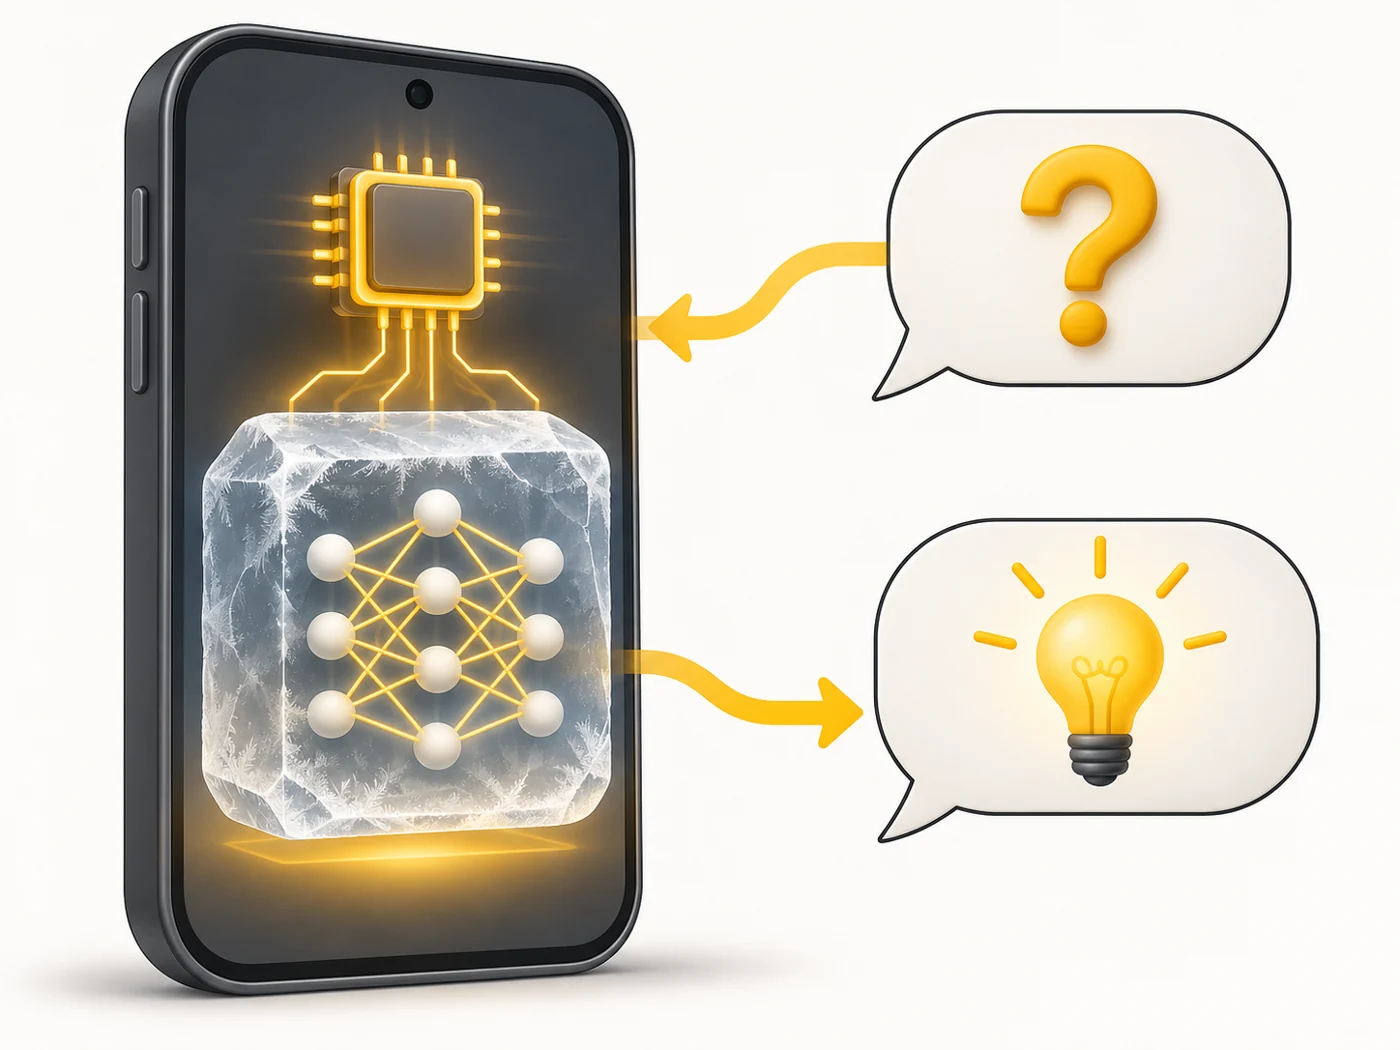
- Tras el entrenamiento, los parámetros se «congelan»: el modelo está listo.
- La inferencia es pasar una petición una vez por el modelo terminado, sin cambiar los parámetros.
- La inferencia puede ir en la nube o directamente en tu móvil si el modelo es pequeño.
Dónde lo verás
Cuando un fabricante dice que una función de IA funciona «en el dispositivo», habla de inferencia: el modelo se entrenó antes, en servidores. El procesador neuronal (NPU) del móvil está hecho sobre todo para la inferencia. Y las noticias sobre «los mayores centros de datos de IA» hablan casi siempre de entrenamiento.
¿Importa al elegir?
Entenderlo ayuda a no tragarse el marketing. El móvil no «aprende» desde cero: ejecuta un modelo ya hecho. Por eso importan la velocidad de la NPU y la cantidad de RAM: que el modelo quepa y responda rápido. Para la mayoría, la inferencia en la nube también está bien si hay internet y no te importa enviar los datos.
Mitos
- Mito: El modelo aprende de cada conversación que tengo. En realidad: Normalmente no: en la inferencia los parámetros no cambian. Los servicios pueden usar las conversaciones para entrenamientos futuros, pero es un proceso aparte que a menudo puedes desactivar.
- Mito: La inferencia es barata. En realidad: Una petición sí, pero miles de millones al día les cuestan a las empresas muchísima energía.
Preguntas frecuentes
¿Qué es más caro, entrenar o inferir?
Entrenar un modelo grande es carísimo, pero la inferencia para millones de usuarios puede acabar costando aún más con el tiempo.
¿Puede un móvil seguir entrenando un modelo?
Solo un poco y en casos concretos: por ejemplo, el teclado se adapta a tus palabras.
¿Qué es un «acelerador de IA»?
Un chip especial para cálculos de redes neuronales, desde la NPU del móvil hasta grandes placas de servidor.
Términos relacionados
Procesador neuronal (NPU), IA en el dispositivo, IA en la nube, Ajuste fino, Parámetros del modelo