Model AI Agibot WITA-Omni przyjmuje dźwięk, obraz, dotyk i informacje o stanie robota. Może generować mowę, ruchy oraz mimikę podczas interakcji z ludźmi.
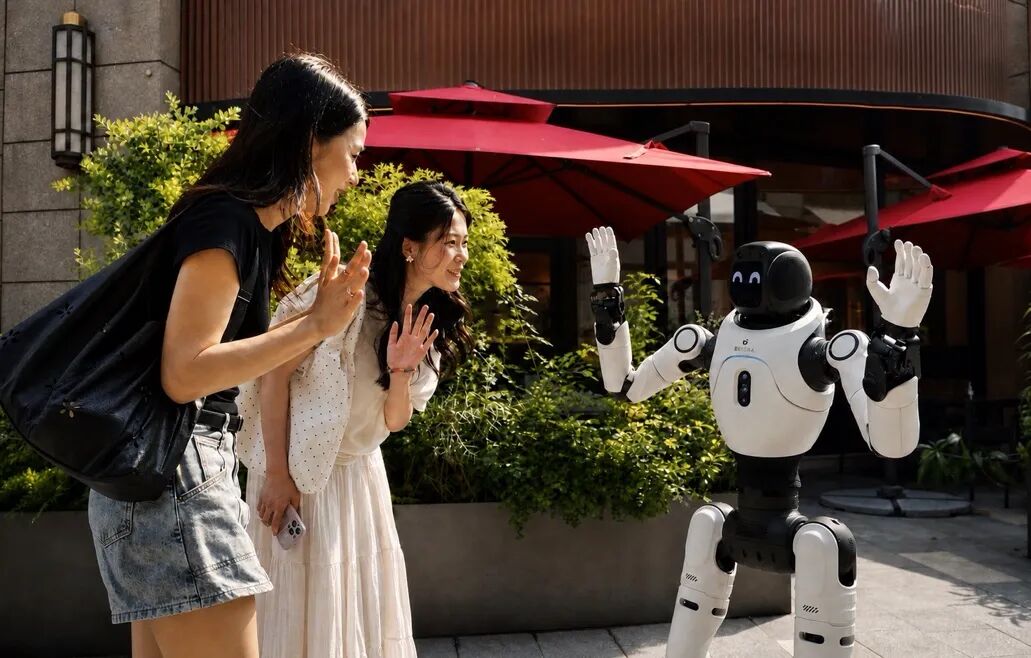
Źródło zdjęcia: IT之家 — zdjęcie ilustracyjne robota
Producent deklaruje pełny dupleks, reakcję od 400 ms, rozmowy bez hasła aktywującego i ponad sto języków oraz dialektów. Są to dane firmy, bez niezależnej weryfikacji.