Agibot оголосила про випуск WITA-Omni — мультимодальної моделі для взаємодії роботів із фізичним світом. Окрім аудіо та відео, вона приймає дані дотику й стану самого робота, а серед виходів підтримує рухи та вирази обличчя.
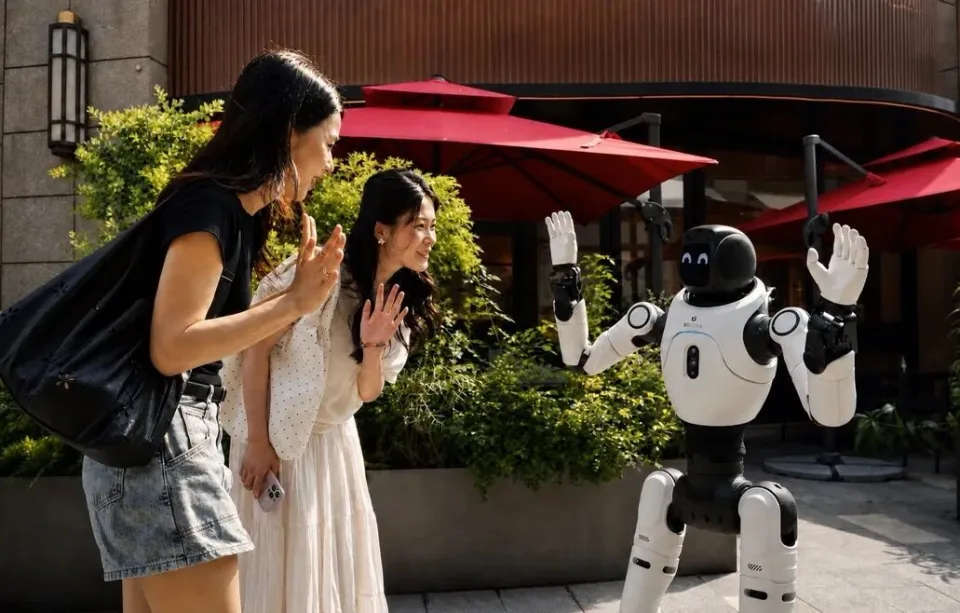
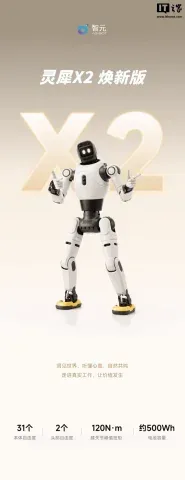
Джерело фото: IT之家 — ілюстративне фото робота
Заявлена потокова повнодуплексна архітектура має дозволити роботу слухати, формувати відповідь і рухатися одночасно. За даними компанії, найшвидший відгук становить близько 400 мс, середній — близько 600 мс. Незалежної перевірки цих цифр у повідомленні немає.
WITA-Omni також заявляє спілкування без слова активації, врахування напрямку розмови, голосу й рухів губ, а також підтримку понад ста мов і діалектів. Серед сценаріїв — синхронний переклад, емоційні реакції та виведення пояснень на екран обличчя робота. Анонс стосується моделі ШІ, а не нового серійного робота.
Відгуки / Коментарі (0)
Коментарів поки немає.